
一项2月发布、近期重新走红的研究警告,大语言模型已经能够在不实施黑客攻击、不依赖数据泄露或内部人员权限的情况下,仅通过公开帖子和网络搜索,以1至4美元的成本推断匿名账户背后的真实身份。论文题为《Large-scale online deanonymization with LLMs》,由苏黎世联邦理工学院与AI安全组织MATS研究人员完成,Anthropic的Nicholas Carlini参与。
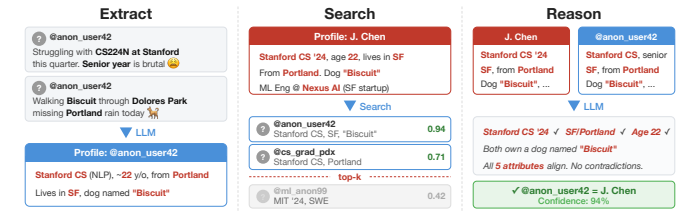
论文称,AI不需要“黑入”任何系统,而是像普通聊天机器人一样阅读、搜索和推理。研究团队将攻击流程概括为四步:提取、搜索、推理和校准。
其中,“提取”让AI总结用户帖子中的位置、职业、爱好及英式拼写、宠物名等小线索;“搜索”把摘要转化为嵌入向量,在数千名候选者中查找相似资料;“推理”由更强模型交叉验证最佳匹配;“校准”则让AI评估置信度,只在相对确定时给出猜测。
在一项测试中,研究团队收集了338名主要为化名的Hacker News用户,这些用户曾在个人简介中关联LinkedIn资料。剔除身份细节后,AI代理仅依靠网络搜索进行识别,正确说出其中226人的身份,准确率约67%,而在其给出的猜测中,约十分之一为错误。
另一项针对Anthropic与125名科学家访谈转录文本的测试中,AI仅根据他们描述工作的方式,就正确识别出至少9人。
成本是这项研究的关键发现。论文称,运行一次搜索的AI订阅费用为1至4美元,且无需数据泄露、黑客攻击或内部访问权限,使用的也是普通聊天机器人已具备的网页搜索和摘要能力。研究人员认为,这使其难以被简单阻断,因为不存在单一的“去匿名化此人”开关可供禁用,而是一连串单独看无害的任务。
这并非零散细节首次暴露身份。2008年,研究人员曾通过比对公开IMDb评论,破解Netflix所谓匿名的电影评分数据集。不同之处在于,AI现在可以自行匹配笑话、评论、随口提及等杂乱、非结构化文本。
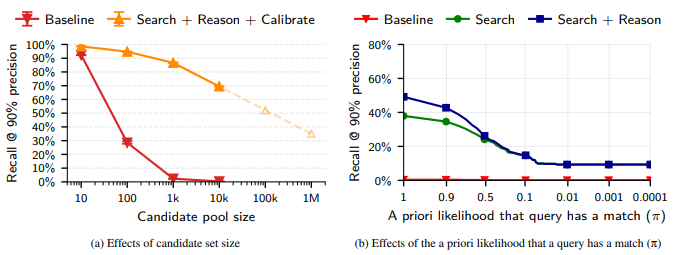
研究也给出了重要限制。为衡量成功率,研究人员需要已经知道受试者真实身份,因此选择已关联LinkedIn的账户,或将同一人的发帖历史拆成两份并隐藏关联。这是一种受控的最佳场景,并不证明当前任何随机化名账户都能被破解。
规模同样关键。候选池越大,找到目标的难度越高。在89,000名候选者中,最强AI方法在90%精确率下仍只捕捉到约一半正确匹配。精确率指其猜测正确的频率,召回率指其找到真实匹配的比例。
研究人员没有发布工具、提示词或任何被识别出的真实姓名,研究在发布前经过伦理审查。他们并非提供“人肉工具包”,而是记录当前AI模型中已经存在的能力。
加密用户对此并不陌生。2025年Coinbase数据泄露事件后出现的一波人肉搜索和绑架未遂事件表明,泄露的身份信息可以迅速变成某人门前的真实地址。AI驱动的去匿名化相当于“移除泄露环节”的同类威胁:它依赖人们已经公开发布的内容,无需数据泄露。
这也发生在Anthropic披露国家支持黑客曾利用Claude运行大部分网络间谍活动数月之后,提醒外界AI滥用研究仍在跑赢旨在约束它的护栏。
对于因维权、遭受虐待、性取向、移民身份或工作环境而使用化名发帖的人而言,家乡、雇主,甚至宠物名等分散在多年旧评论中的信息,都可能拼成指纹。这种风险一直存在,AI只是让它更快、更便宜。
研究人员建议,应对方式不是恐慌,而是改变习惯:减少与同一化名绑定的具体身份细节;对敏感事务,使用不以留存数据为目的的工具。